Kinam Kim

Ph.D. Student ยท KAIST AI

Kinam Kim

I am a Ph.D. student at KAIST AI, advised by Prof. Jaegul Choo. I am currently a research intern at NVIDIA, previously at Microsoft Research Asia.

My research is on robot foundation models: Vision-Language-Action (VLA) models and world models built on video generative priors. I work on what it takes to make them run on real robots, from reinforcement learning and zero-shot sim-to-real transfer to generating dexterous manipulation data at scale without teleoperation.

If you have any questions or suggestions, please feel free to contact me via email (kinamplify@kaist.ac.kr)!
News

Experience

Publications

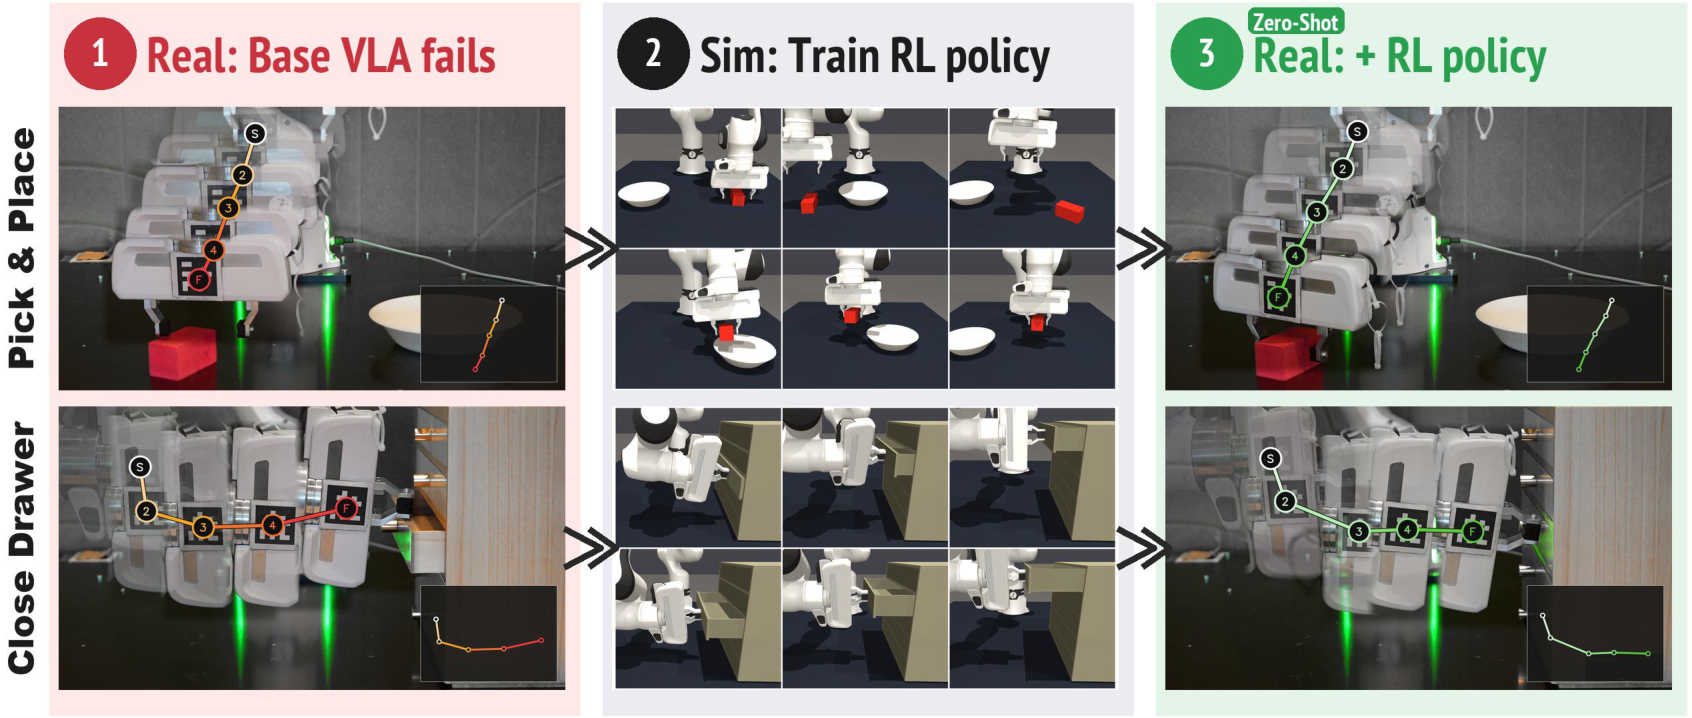
teaser: Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement

Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement

Kinam Kim, Namiko Saito, Heecheol Kim, Katsushi Ikeuchi, Jaegul Choo, Yasuyuki Matsushita
CoRL 2026
Work done during an internship at Microsoft Research Asia
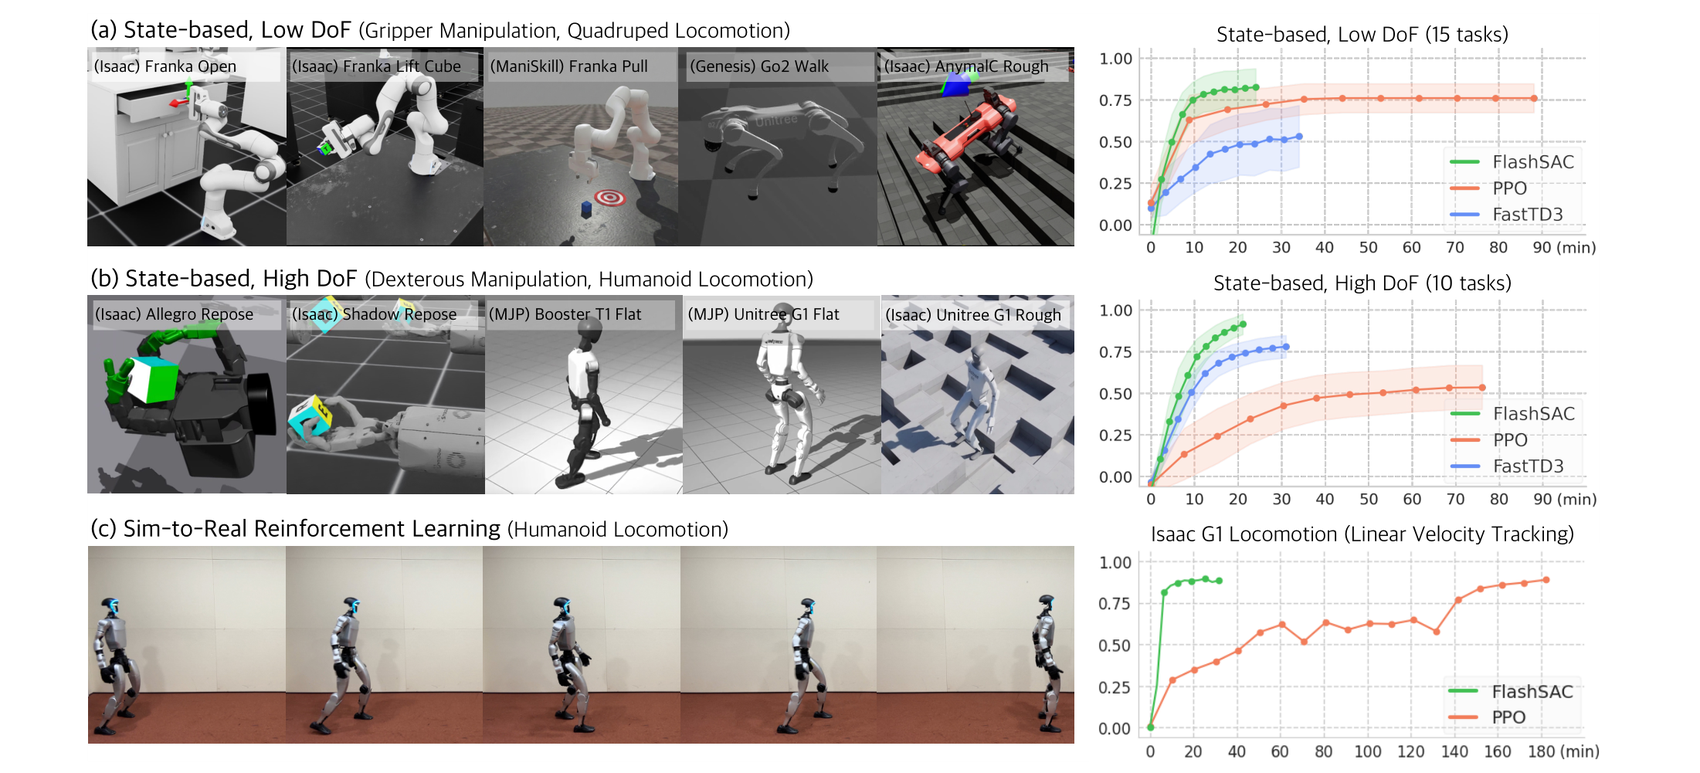
teaser: FlashSAC

FlashSAC: Fast and Stable Off-Policy Reinforcement Learning for High-Dimensional Robot Control

Donghu Kim*, Youngdo Lee*, Minho Park, Kinam Kim, I Made Aswin Nahendra, Takuma Seno, Sehee Min, Daniel Palenicek, Florian Vogt, Danica Kragic, Jan Peters, Jaegul Choo, Hojoon Lee (* equal contribution)
RSS 2026
Outstanding Paper Award
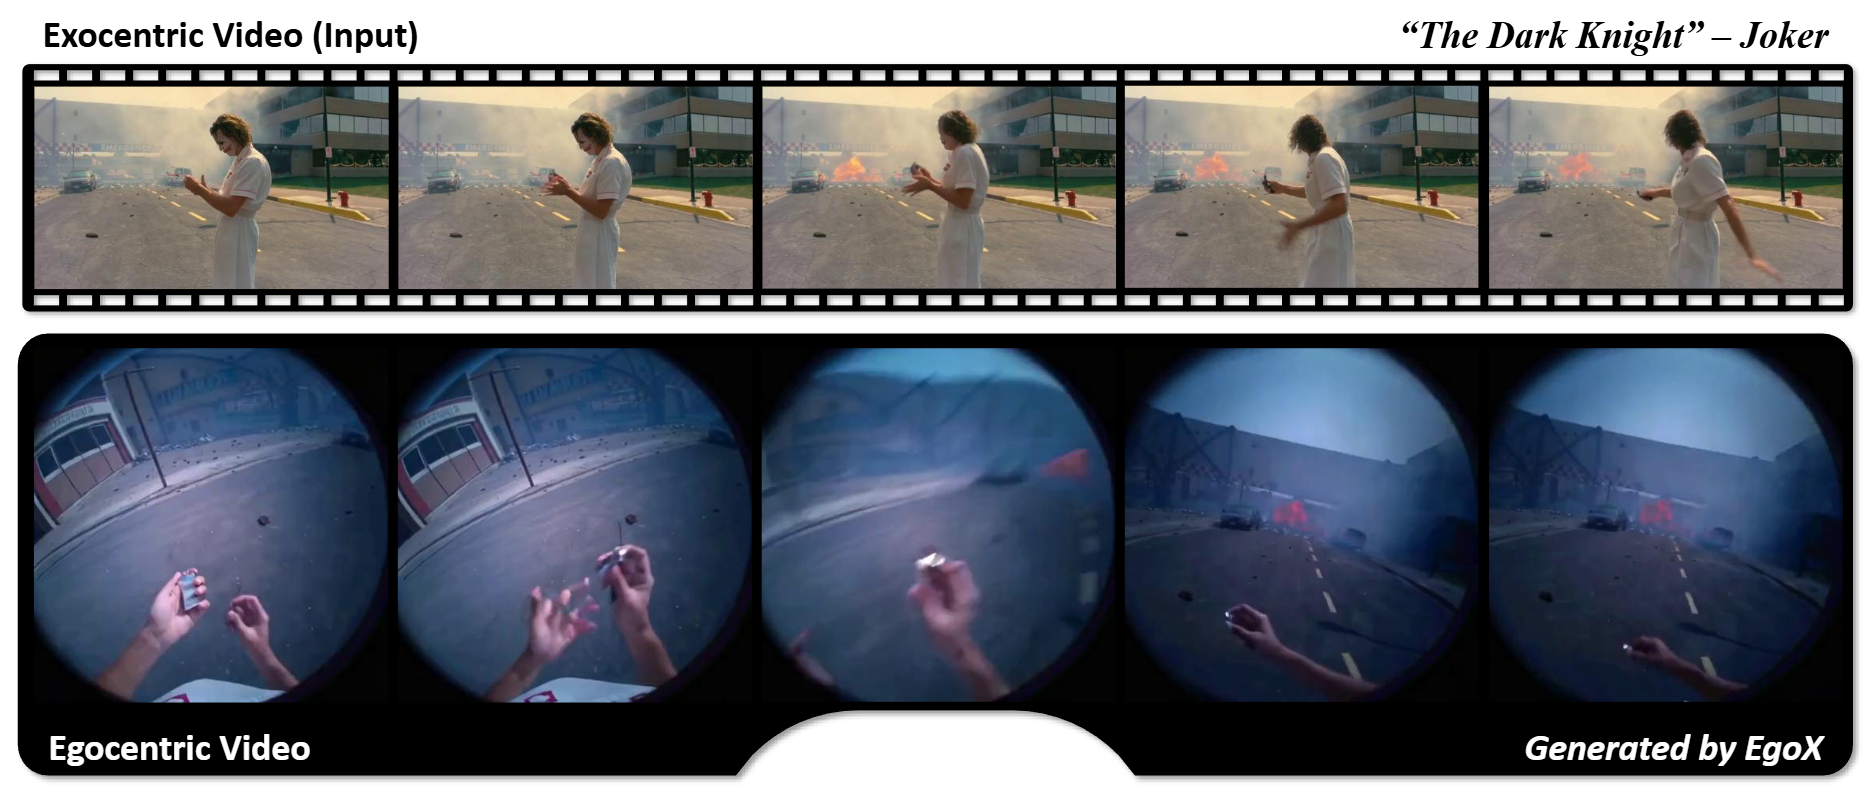
teaser: EgoX

EgoX: Egocentric Video Generation from a Single Exocentric Video

Taewoong Kang*, Kinam Kim*, Dohyeon Kim*, Minho Park, Junha Hyung, Jaegul Choo (* equal contribution)
CVPR 2026
teaser: ACG

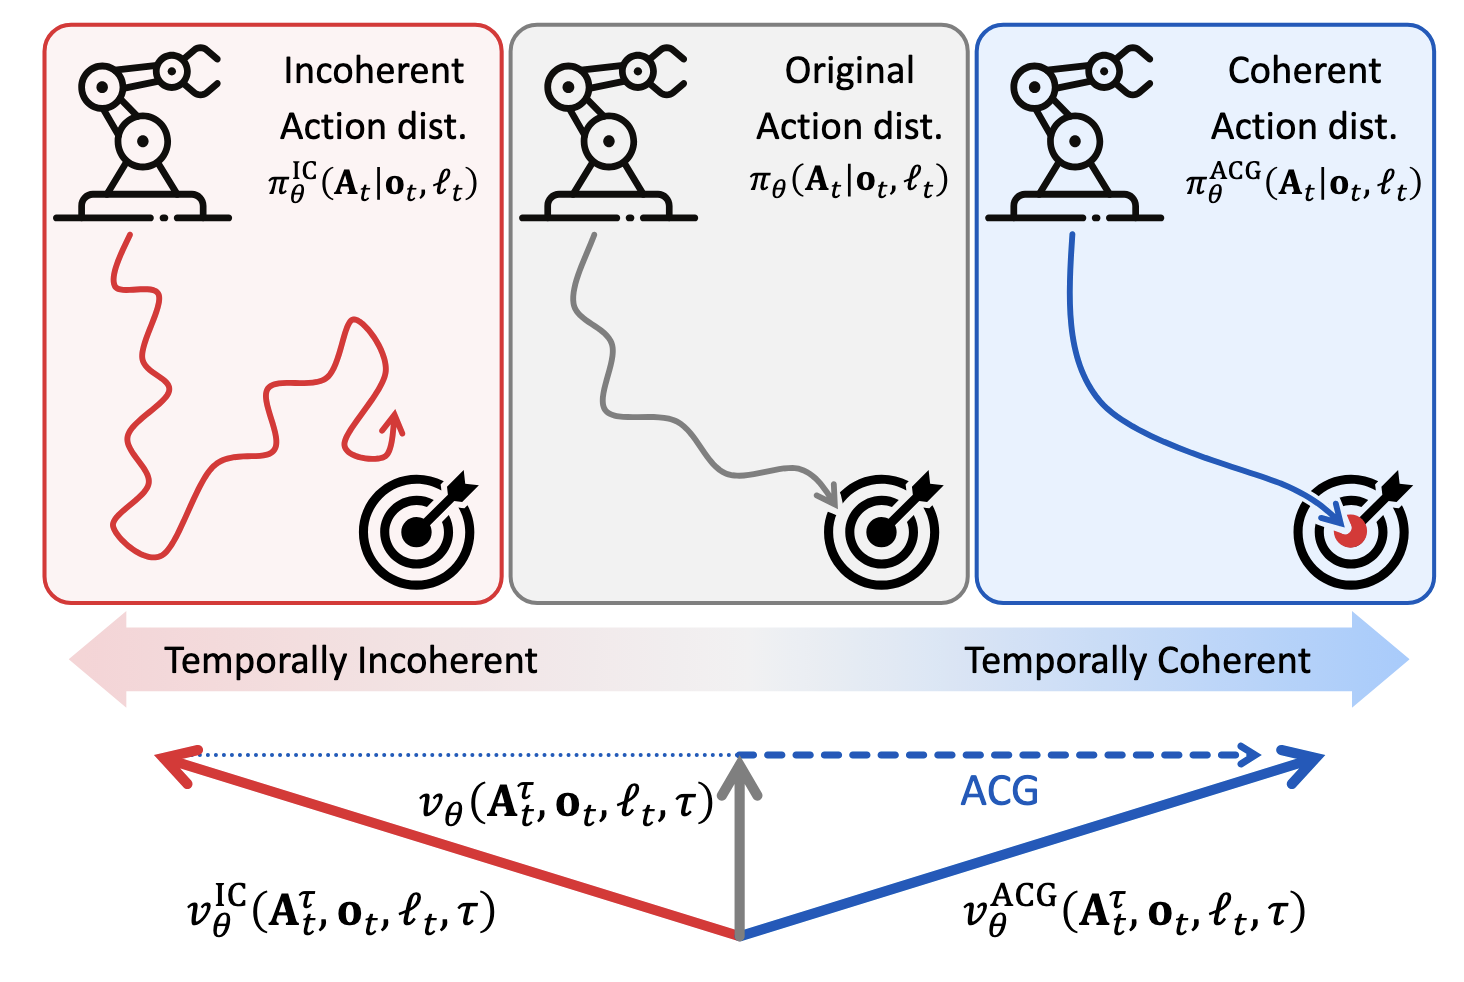
ACG: Action Coherence Guidance for Flow-based VLA Models

Minho Park*, Kinam Kim*, Junha Hyung, Hyojin Jang, Hoiyeong Jin, Jooyeol Yun, Hojoon Lee, Jaegul Choo (* equal contribution)
ICRA 2026

Temporal In-Context Fine-Tuning for Versatile Control of Video Diffusion Models

Kinam Kim*, Junha Hyung*, Jaegul Choo (* equal contribution)
NeurIPS 2025

Spatiotemporal Skip Guidance for Enhanced Video Diffusion Sampling

Junha Hyung*, Kinam Kim*, Susung Hong, Min-Jung Kim, Jaegul Choo (* equal contribution)
CVPR 2025
teaser: CREPA

Cross-Frame Representation Alignment for Fine-Tuning Video Diffusion Models

Sungwon Hwang*, Hyojin Jang*, Kinam Kim, Minho Park, Jaegul Choo (* equal contribution)
arXiv 2025
teaser: Overcoming Camera-Facing Gaze Bias in EG3D Scene Generation

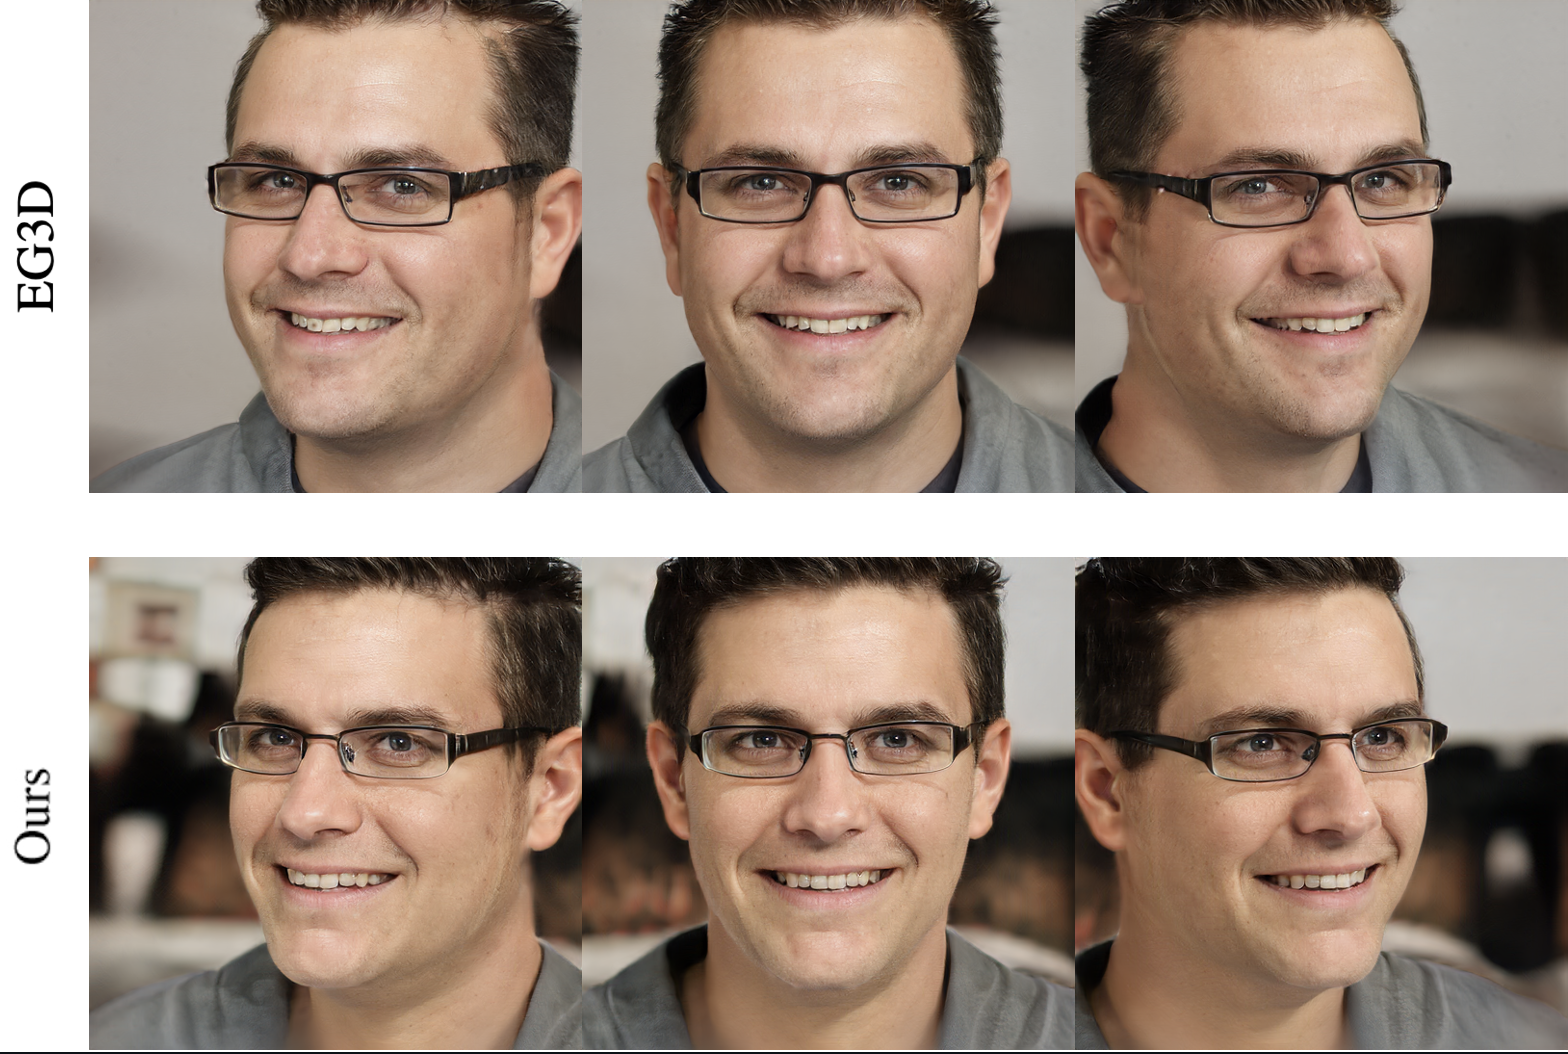
Overcoming Camera-Facing Gaze Bias in EG3D Scene Generation

Kinam Kim, Juhyun Lee, Youngdo Lee
arXiv 2023

Education